30年清华智能体大赛,迎来一批特殊的“新选手”
你那一届智能体大赛,打的是什么游戏?是提瓦特大陆上的 Generals,还是学术迷宫里的 Rollman?
你是否也曾盯着一场回放,琢磨如何利用规则打出自己的战术:这一轮为什么没抢到先机,那次进攻为什么功亏一篑,对手看似不起眼的一步,又是怎样打乱了整套计划?
读规则时,脑海里已经有了好几种漂亮的打法;真正上场后,才发现对手总有自己没想到的招数。于是,你重新翻开规则,仔细查看回放,把一个新想法写进代码,再提交、再对战。修好了眼前的漏洞,却又遇到新的克制;好不容易爬上几名,便忍不住再看看榜单,想知道离前面的高手还差在哪里。
智能体大赛的乐趣,往往就在这些时刻:一个藏在规则里的机会,一次从失败中找到的转机,还有那份终于在下一场对局中奏效的策略。你写下的不只是一段程序,也是自己对这场游戏的理解。
对清华大学计算机系而言,智能体大赛不只是一场程序比赛,更是一份延续近三十年的共同记忆。赛题和选手不断变化,那个熟悉的挑战始终未变:把对规则的理解、对局势的判断和对对手的应对,写成真正能上场的程序。一代代选手把热爱与思考留在代码里,也留下了珍贵的人类程序存档。
如今,清华大学计算机系学生科协尝试让 AI Agent 也走过这段路。在《Can AI Agents Learn Their Way to the Top? Evaluating Heuristic Learning in a Long-Running Game Agent Competition》这项研究中,我们把 AI Agent 放到了人类选手的位置上:让它们自己读规则、选对手、看回放,一版版修改策略,向人类高手留下的榜单发起挑战。
这批特殊的新选手,能冲上榜首吗?
论文链接:https://arxiv.org/abs/2610.12341
项目主页:http://aaarena.net
开源代码:https://github.com/THU-CST-SAST/AAArena/
HF Daily Paper:https://huggingface.co/papers/2610.12341
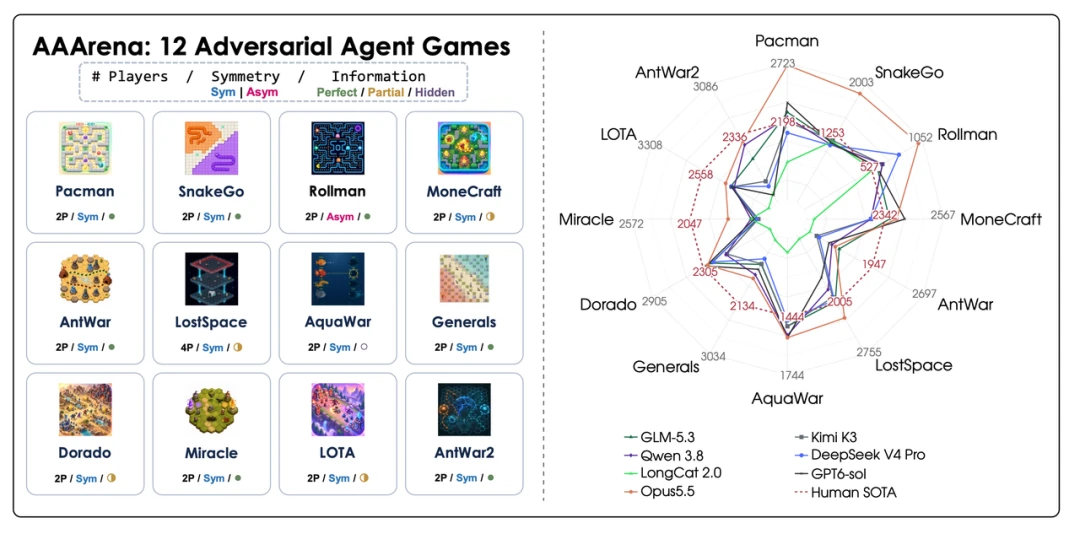
游戏概览和模型雷达图
从人改策略,到 Agent 改策略
Jiayi Weng 在《Learning Beyond Gradients》中讨论了启发式学习的概念(Heuristic Learning,HL):让Agent作为学习器,根据经验与反馈,直接改进程序等可执行结构。
回头看,每一届选手的参赛过程,不正是一种由人驱动的启发式学习吗?读懂规则,写出第一版策略;找对手测试,回看失败的对局;发现问题,再把新的判断写进代码。选手自己,就是这个过程中的“学习引擎”,将对局经验一点点转化为程序的进步。
沿着这一思路,我们尝试把学习引擎换成 AI Agent,将 HL 在对抗任务中的实现形式化为对抗启发学习(Adversarial Heuristic Learning,AHL)。基础模型权重保持固定,由 Agent 理解规则、选择对手、分析反馈并生成和维护用于对局的游戏智能体。
直观上,Agent 有望更持久地反复测试、更系统地整理回放,并从不同选手的经验中寻找策略灵感。但这些优势能否转化成赛场上的胜算,仍需要真正的对抗来检验。
为此,我们依托历年赛事积累,构建了 AAArena,收录 12 个历年比赛游戏与 1,920 份人类程序存档,让 Agent 像人类选手一样,在读规则、打对局、改程序的过程中争夺榜单。
为了给不同 Agent 一把共同的尺子,每个游戏设置 128 个小对局单位与 16 次完整对手池评测:前者用于自主选择对手、对战并读取回放,后者返回当前策略的 Elo 与排名。Agent 自主安排学习和提交的节奏,最终以预算内历史最高的正式成绩参与比较。
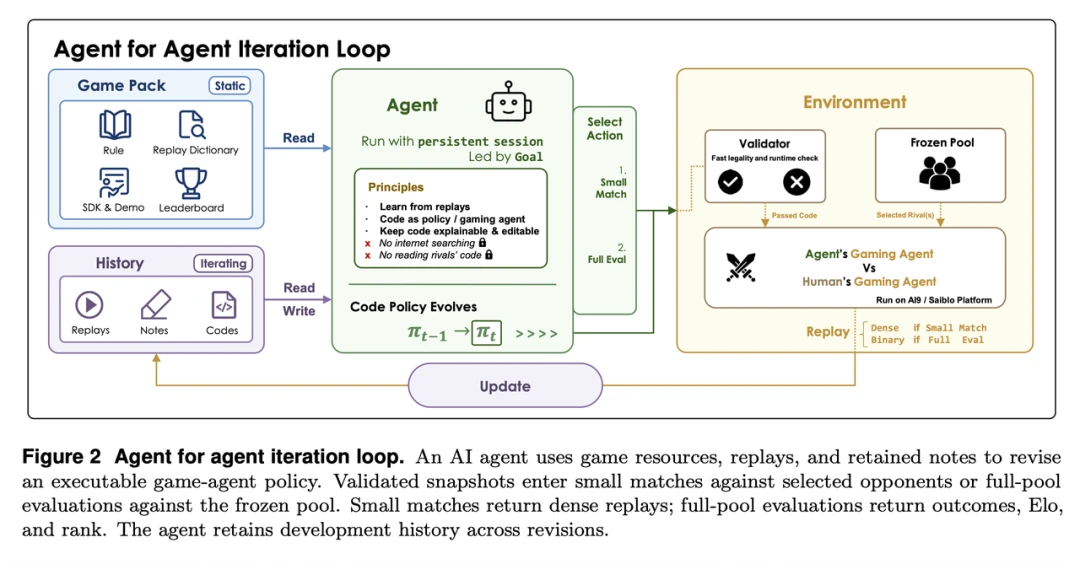
AHL的方法框架图
对 7 种 AI 模型及其运行配置的评测显示:Opus5.5 与 Claude Code 的组合获得了 6 枚金牌,但另外 6 个榜单仍未被任何已测配置登顶。这套学习方式已经让 Agent 在部分游戏中匹敌人类高手,也让那些尚未攻克的游戏,成为观察其能力瓶颈的窗口。
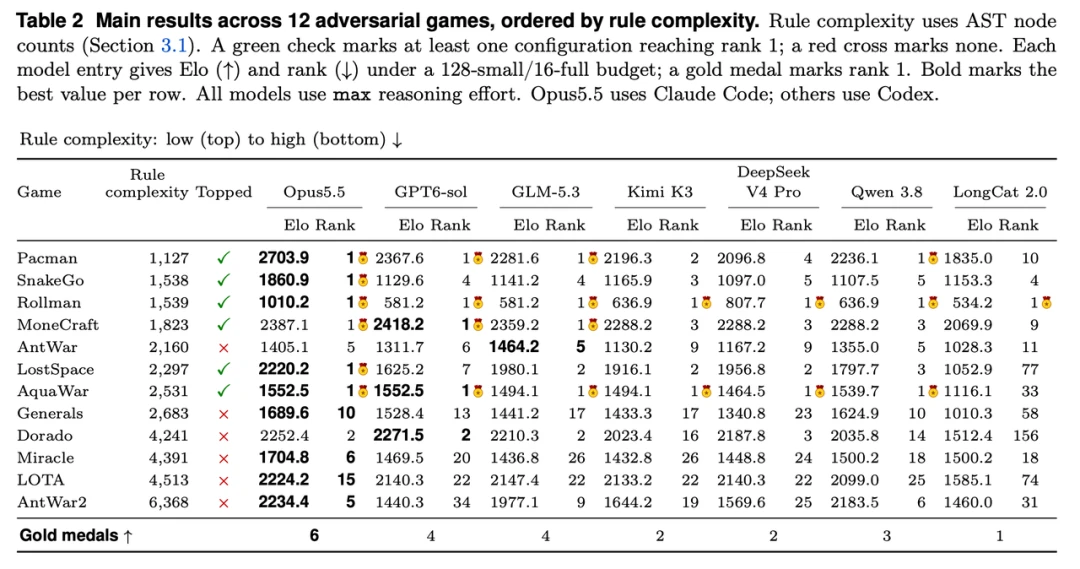
七种模型配置在12个游戏上的Elo、排名与金牌数;金牌🏅为固定人类存档榜单中的第1名。
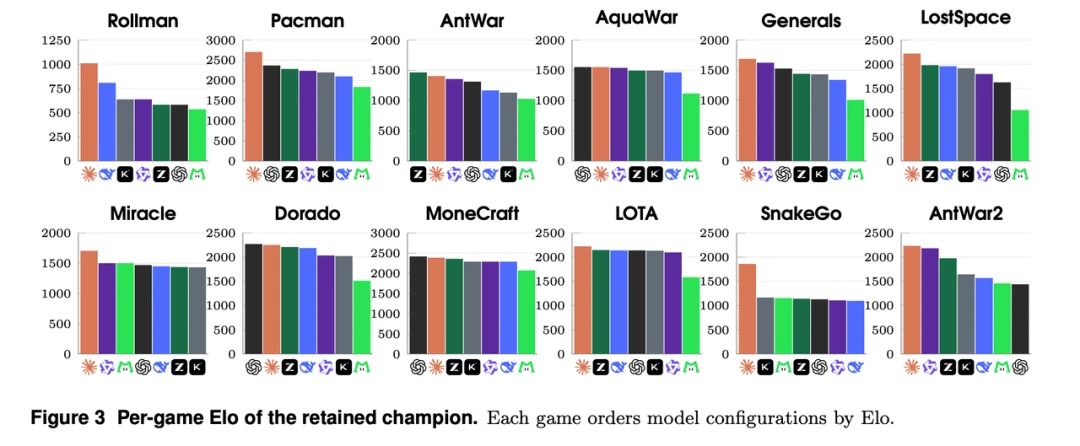
各模型等级分柱状图
6枚金牌之外的挑战:当规则变得复杂
在 12 个游戏中,Opus5.5 与 Claude Code 的组合获得了 6 枚金牌,但仍有另外 6 个榜单未被任何已测模型登顶。在 LOTA、Generals 和 Miracle 上,最好配置分别位列第 15、10、6 名。
一个突出的观察是:面对复杂规则,Agent 更容易陷入策略改进的瓶颈。当资源、时间窗口和多种机制相互制约时,难点不只是读懂每条规则,而是把它们整合成完整的决策逻辑。
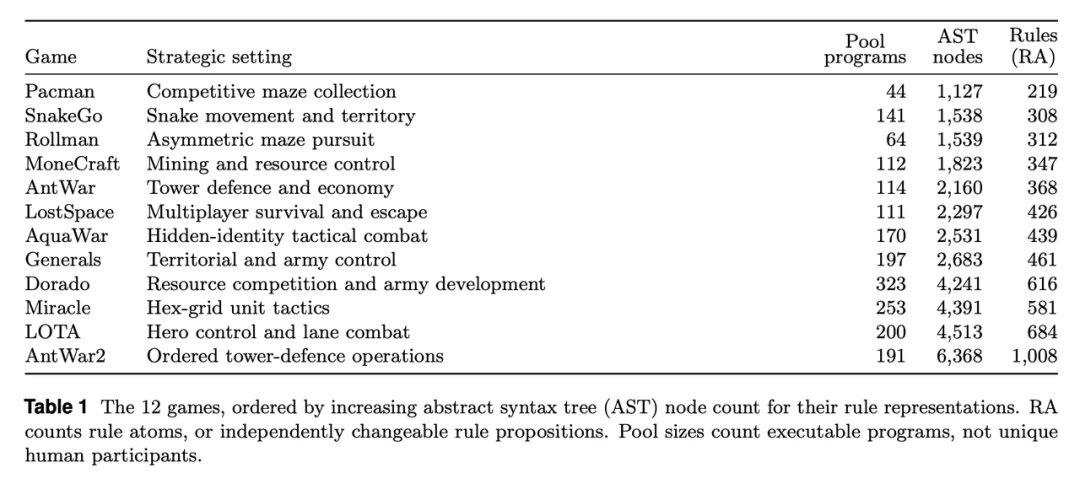
团队采用统一的形式化伪代码描述各个游戏,并以抽象语法树节点数(AST)和可独立修改的规则命题数量(RA)衡量规则复杂度,发现整体上,越为复杂的游戏,AI 选手的表现越差。
增加预算也未必能跨越这道门槛。对 GLM-5.3 在 4 个困难游戏中的续跑实验显示,交互预算增加到 3 倍后,2 个游戏没有提升,另外 2 个只有有限进展,均未登顶。多写代码、多做测试,并不会自动变成更深的理解;关键仍是能否从反馈中找到有效的策略改进方向。
规则复杂度与长期改进:上图为 12 个游戏的 AST / RA 统计,下图为 4 个困难游戏在 3 倍交互预算下的续跑轨迹。
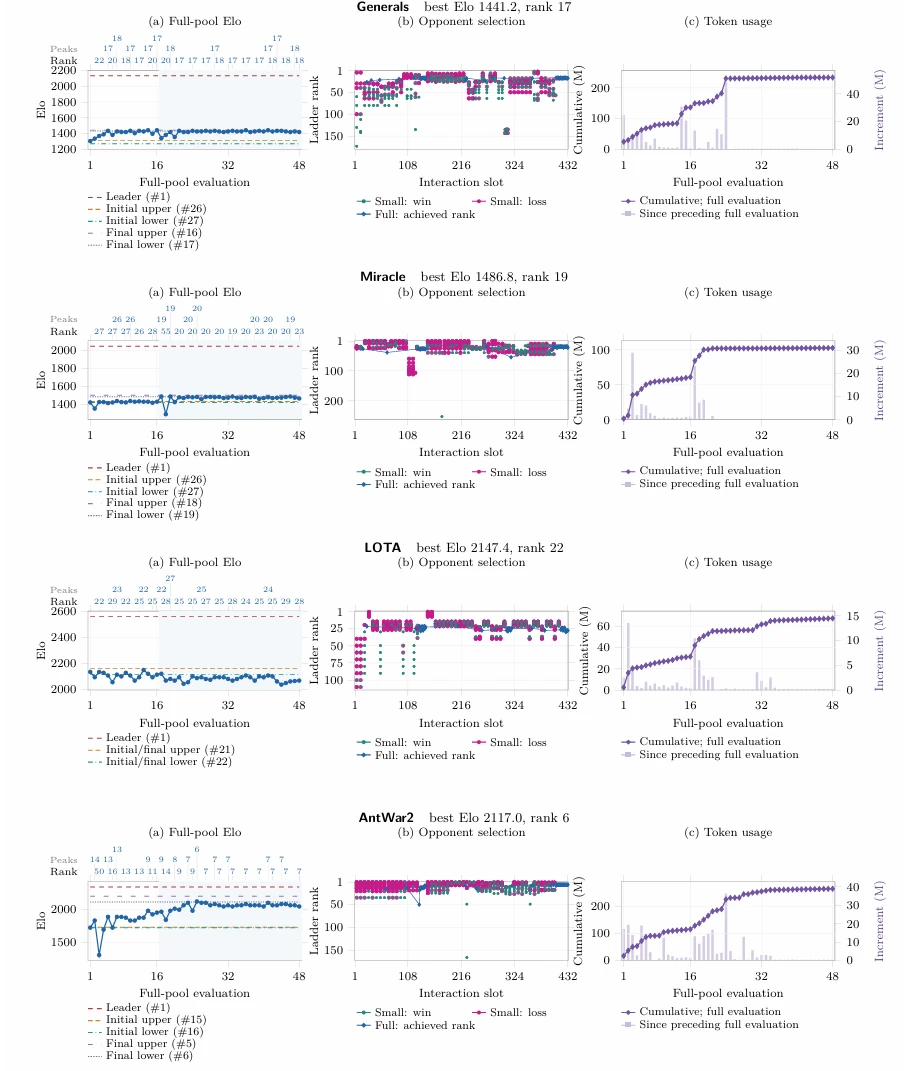
四个困难游戏的三倍预算续跑:左为策略 Elo,中为对手选择,右为 token 消耗。
成长的关键:在对局中有效学习
在赛场上,如何从反馈中学习是最后能否登顶的决定因素。消融实验考察了对手选择策略、信息反馈方式,以及交互批大小:该向谁挑战,失败后能看到什么,一轮积累多少经验。这些选择共同塑造了 Agent 的学习过程。
选择对手:挑战最强者,未必最利于学习
对手选择可以理解为对学习样本的主动安排。我们比较了自主选择、阶梯式挑战、随机抽样和只挑战最强四个对手。在三个代表游戏中,自主选择或阶梯式挑战表现更好。挑战最难的对手,总是失败的情况下,往往无法获取充足的改进信息;而不管自身情况随机抽样对手,则可能找到大量无效信息。只有根据自身具体情况选取动态选取有价值的对手,才能不断在对局中成长。这些结果说明,Agent能否自主选择最有价值的对手,将会是对抗场景中的关键变量。
稠密回放:从“输了”走向“为什么输”
AHL相比强化学习的一大特点就是它能够接受稠密的反馈信号输入,这个更宽的输入信号通道是否对结果有显著影响呢?答案是肯定的。
团队对是否提供稠密回复进行了消融。在 Pacman、AntWar、Miracle 中,详细回放相对二值反馈分别带来约 526、238、67 Elo的提升。只给 0/1 胜负反馈,Agent 能知道结果,却很难定位失败原因。稠密回放提供了状态、动作和对手反应,使它可以沿着决策过程分析问题,并把解释落实为具体的代码修改,更高效地修改策略。
而这个特点,也是 AHL能够在极少的样本反馈(128 对局)的情况下仍能登顶榜单的关键。
交互批大小:如何利用有限的交互预算
深度学习中的随机梯度下降中,批量大小的概念非常关键,它是达到效率和训练稳定性平衡的关键因素。
在 AHL中,这个概念可以延伸到两次更新之间该测试多少对手。
增大批量,有利于提高训练稳定性:一次只测试一个对手,获得的经验可能过于局部,而适当增加批大小,可以让 Agent 比较不同对手下的失败模式。
但是,在有限交互预算下,批量过大也会更快消耗预算,减少后续策略继续试错的机会。
因此,如何权衡有限的预算和稳定更新是相当重要。在本次消融设置中,每批2–4 个对手表现更优,而不是批量越大越好。像选手安排训练一样,Agent 需要兼顾经验的广度与修改的机会:既看见不同的失败模式,也留下检验下一版策略的预算。
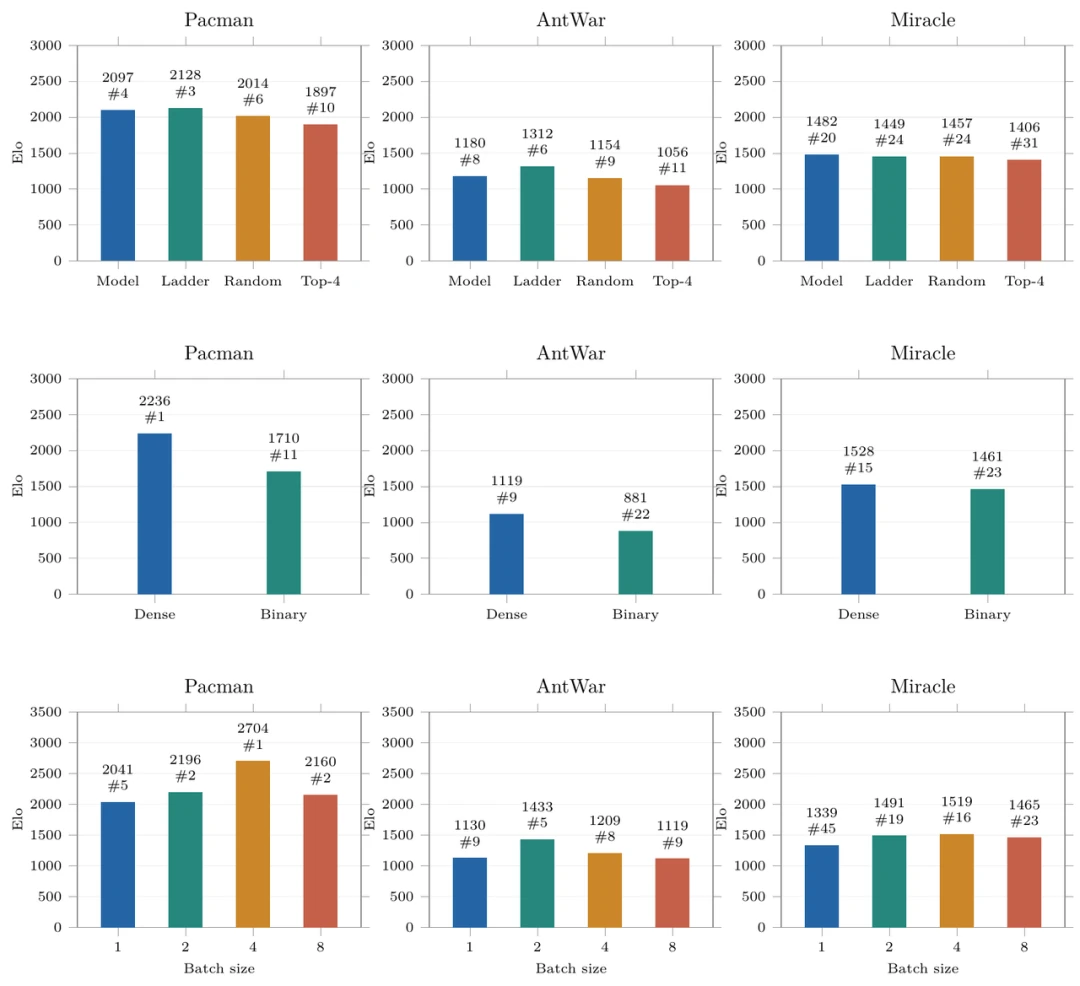
三组消融合图:上为对手选择,中为稠密/二值反馈,下为交互批大小
旁观亦能成才:从他人的对局中学习
人类选手的成长,从来不只局限于自己上场拼杀。复盘别人的对局、观察高手的博弈,往往能为我们带来全新的战术灵感和破局思路。那么,如果主动让 AI Agent 去“旁观”和吸收他人的对局,它能不能也借此实现成才?
为此,团队专门设计了一项补充实验。我们发现,通过主动引导 Agent 读取其他选手之间的对战(即 Off-policy 轨迹样本),AHL 展现出了跨策略学习的潜力。
我们在三个代表性游戏中测试了这一设定,Agent 的策略排名均实现了明显提升:在Pacman 中从 #10 提升至 #1,AntWar 中从 #41 提升至 #19,Miracle 中从 #27 提升至 #15。其中,Miracle 借助外部回放获得的表现,甚至优于自身对局反馈下的第 26 名。
当 Agent 自身陷入探索瓶颈时,主动引入Off policy经验也可能提供关键的突破口。
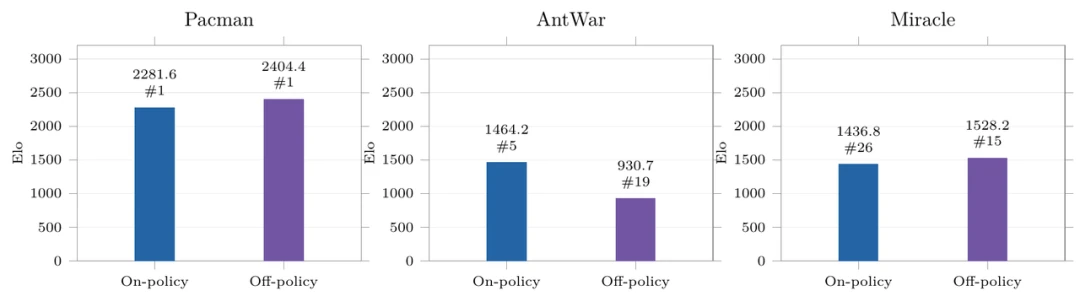
On-policy 与 Off-policy 最佳策略对比:Pacman 均登顶,AntWar 更受益于自身回放,Miracle 更受益于外部回放。
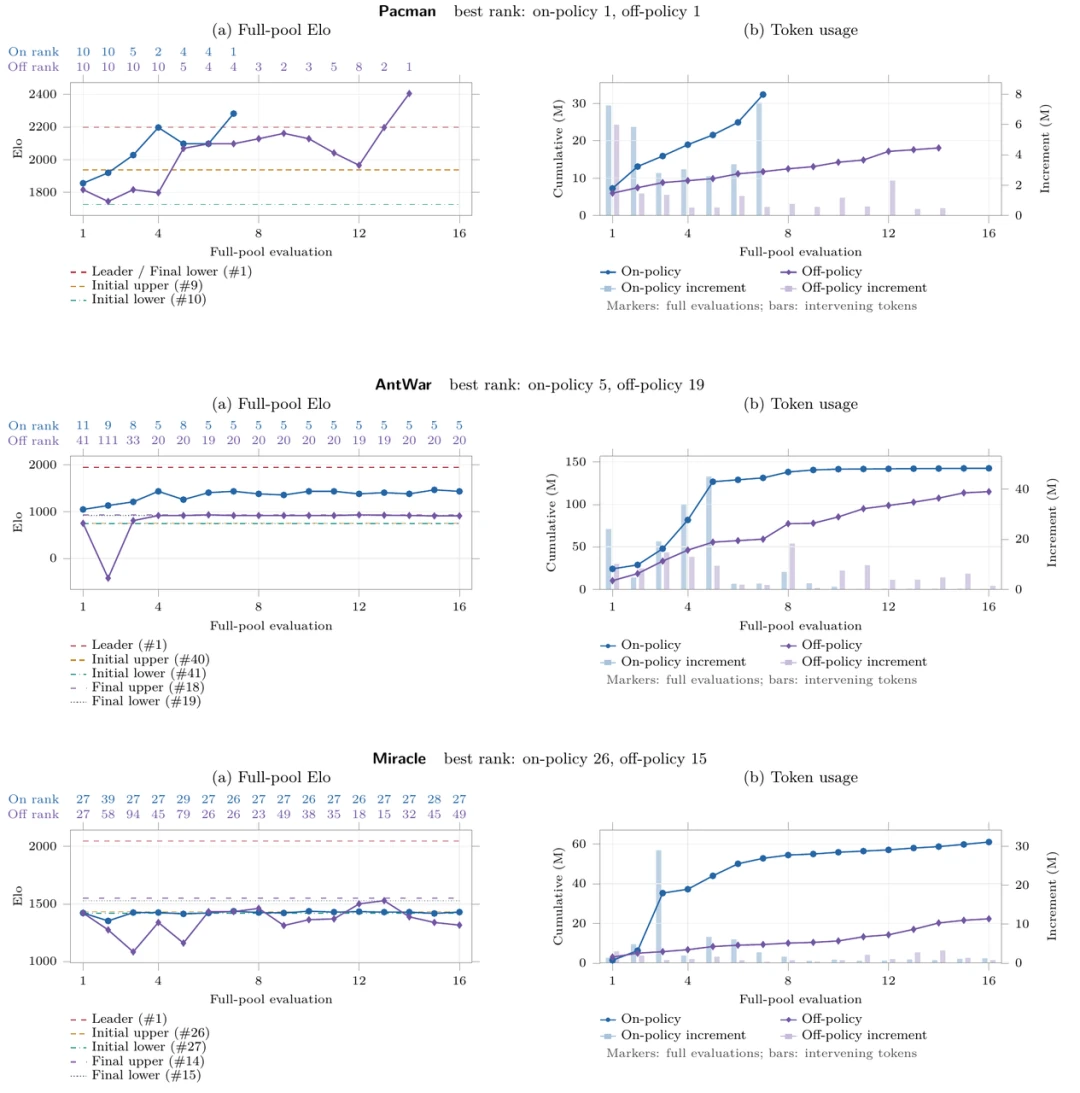
三种游戏的学习轨迹:蓝色为 On-policy,紫色为 Off-policy;右侧为 token 消耗。
AI Agent的下一步
HL 最迷人的地方,在于它让 Agent 能够通过行动与反馈,不断改进自己解决问题的方式。它不受可导性的限制,也不必将所有经验压缩成单一的奖励信号:规则、测试结果、运行日志,乃至与其他选手的对战回放,都可以成为改进策略的依据。Agent 不再只是执行一个既定策略,而是能够在实践中分析问题、修改策略,并通过新的对抗检验自己的改进。 从这个意义上说,HL 展现了 RSI(递归自我改进)的一种具体路径。
现阶段,HL 的改进主要发生在代码等离散对象上。但它的潜力并不止于此。随着分层式 HL 与梯度优化等方法进一步结合,Agent 有望在更高层次上调整解决问题的思路,同时在更细粒度上优化具体策略。这为自我改进从软件开发走向更广泛的任务与环境,打开了新的可能。
智能体大赛正是观察这一能力的一个独特起点。过去三十年,选手们阅读规则、设计策略、编写程序,在一场场对抗中积累经验;今天,AI Agent 开始接过这根接力棒,尝试在同样的规则与竞争环境中,完成理解、编程、试错与改进。这套过程所体现的能力,也与量化投资、网络攻防等现实场景中的挑战相呼应:面对不断变化的对手,如何从有限的交互中提取经验,并将经验转化为更有效的策略。
智能体大赛的三十年,恰与人工智能破浪前行的三十年同频。从人类选手积累的博弈智慧,到 AI Agent 开始探索自主改进的边界,这座赛场承载的不仅是策略的较量,也是一场关于智能如何持续进步的长期探索。新的选手已经入场,而这段故事才刚刚开始。
文案 | 杨凯森 刘青乐 赵一澄
排版 | 李成蹊
审核 | 王圣远 胥嘉政
原文:微信公众号 · 酒井科协